


간단한 정보를 입력하시면
전체 자료를 메일로 보내드립니다.
AI 영상 만드는 법 입문 가이드
AI 영상 만드는 법을 생성 방식, 준비물, 제작 순서로 나눠 19페이지 PDF에 정리했습니다.
AI 영상 생성 방식 4가지
AI 영상은 무엇을 입력하느냐에 따라 네 가지로 나뉩니다. 텍스트만 넣을수록 빠르지만 결과를 통제하기 어렵고, 이미지나 레퍼런스를 넣을수록 원하는 장면에 가까워집니다. 만들 영상에 같은 인물이 계속 나오는지, 제품이나 로고가 정확해야 하는지에 따라 방식을 고릅니다.
입력과 특징
| 방식 | 입력 | 특징 |
|---|---|---|
| T2V | 텍스트 | 이미지 없이 장면을 새로 구성합니다. 인물 생김새나 구도를 고정하기 어렵습니다. |
| I2V | 이미지 1장 | 첫 프레임 이미지를 움직입니다. 장면마다 이미지를 따로 준비합니다. |
| 키프레임 | 시작·끝 이미지 2장 | 두 장면 사이의 움직임을 만들어 의도를 가장 정확히 구현합니다. |
| R2V | 인물·장소·음성 레퍼런스 | 레퍼런스를 유지한 채 여러 컷을 한 번에 만들고 소리도 함께 생성합니다. |
어떤 방식을 고를까
「기본적으로 R2V, 예외적으로 I2V」
떠먹는 AI 콘텐츠 가이드: 영상 편, 5쪽
R2V가 한 편을 완성하기까지의 생성 횟수가 가장 적고 품질도 가장 좋았습니다. 다만 한 번에 원하는 결과가 나온다는 보장이 없어, 제품 패키지나 로고가 정확히 나와야 하는 장면은 I2V와 키프레임을 씁니다.
방식별로 맞는 장면
AI 영상 만드는 법 4단계
생성 버튼을 누르기 전의 준비가 결과를 좌우합니다. 30초 안팎의 광고나 캠페인 영상을 기준으로 한 순서이며, 짧은 쇼츠 한 편이라면 1단계와 2단계를 간단히 줄여도 됩니다.
순서
- 1기획: 씬과 컷마다 시간, 화면, 동작, 대사를 정합니다. Seedance 2.0은 한 번에 최대 15초, 8컷까지 생성하므로 씬 하나를 15초 안쪽으로 나눕니다.
- 2레퍼런스 준비: 등장인물의 대표 이미지를 만든 뒤, 여러 각도를 한 장에 담은 캐릭터시트를 이미지 생성 모델로 만듭니다.
- 3씬별 생성: 캐릭터시트를 레퍼런스로 넣어 씬마다 영상을 생성합니다. 배경음악, 내레이션, 자막은 빼고 대사와 효과음만 만듭니다.
- 4후편집: 씬을 잇고 음악, 자막, 색감을 맞춥니다. 마음에 들지 않는 씬은 그 씬만 다시 생성합니다.
결과 영상 예시
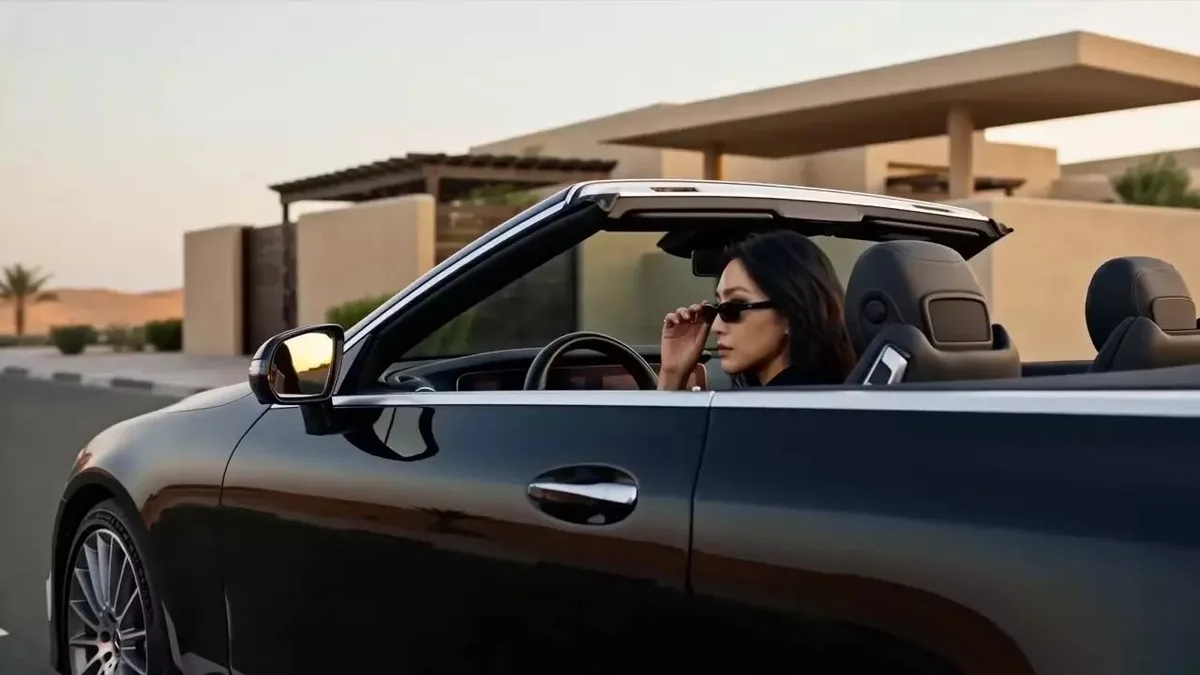
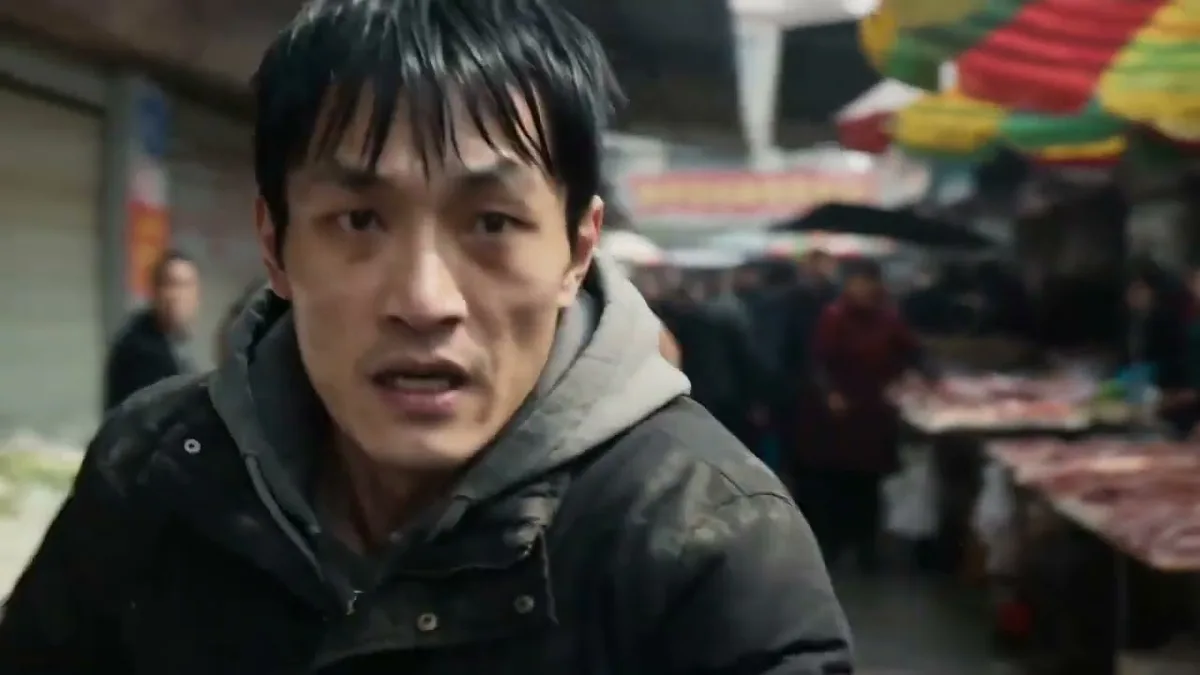
레퍼런스 이미지 한두 장으로 13~15초를 한 번에 생성한 R2V 예시와, 한 인물이 여러 세계를 오가는 브랜드 필름, 씬 세 개를 이어 만든 30초 데모 캠페인입니다. 결과를 볼 때는 컷이 바뀌어도 얼굴과 옷이 유지되는지, 동작이 자연스럽게 이어지는지를 봅니다.
붕괴된 신전에서의 추락 액션
스케이트보드 트릭
사막을 달리는 오픈카
시장 골목 추격
한 인물이 오가는 여러 세계
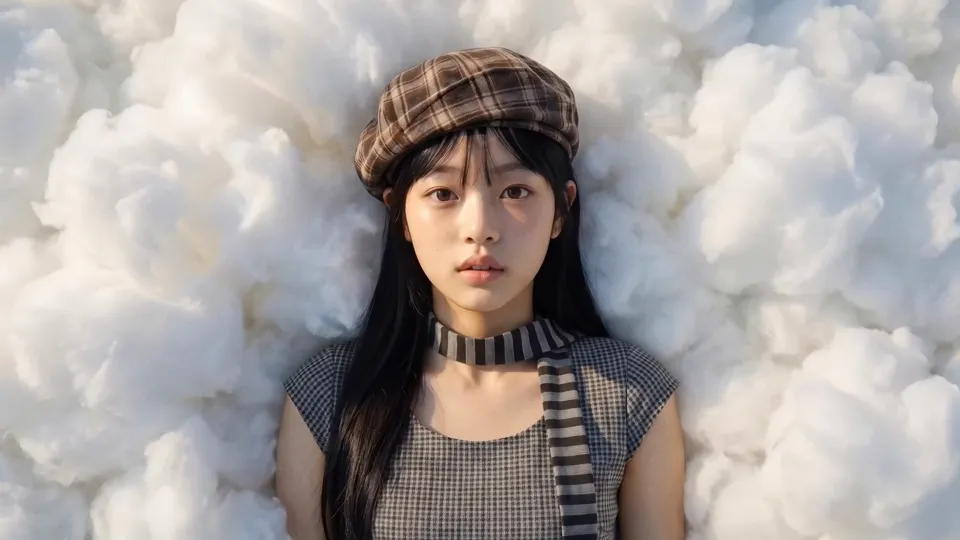
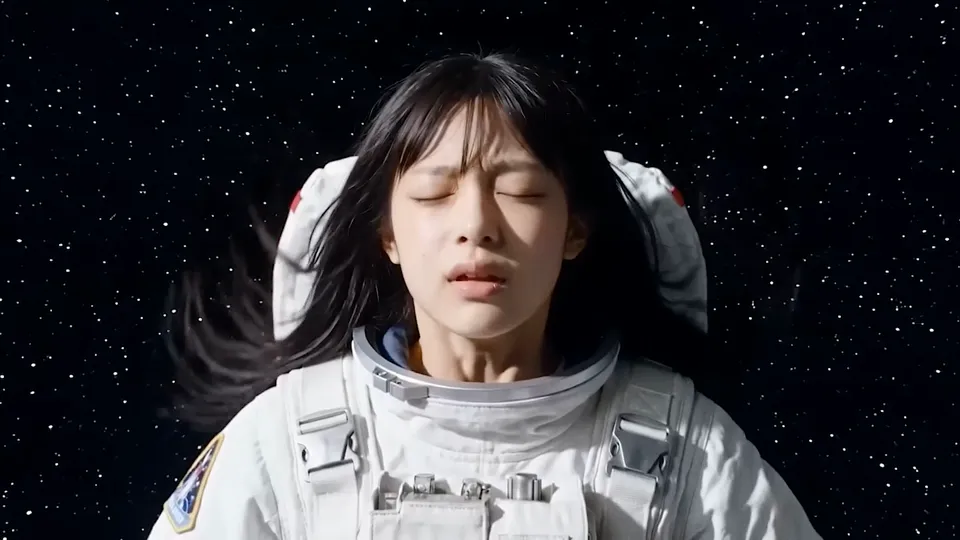
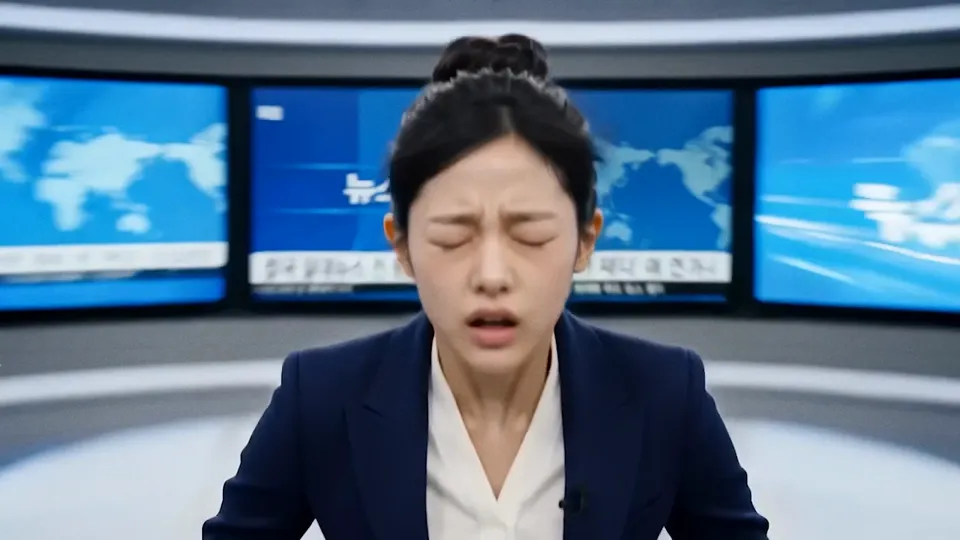
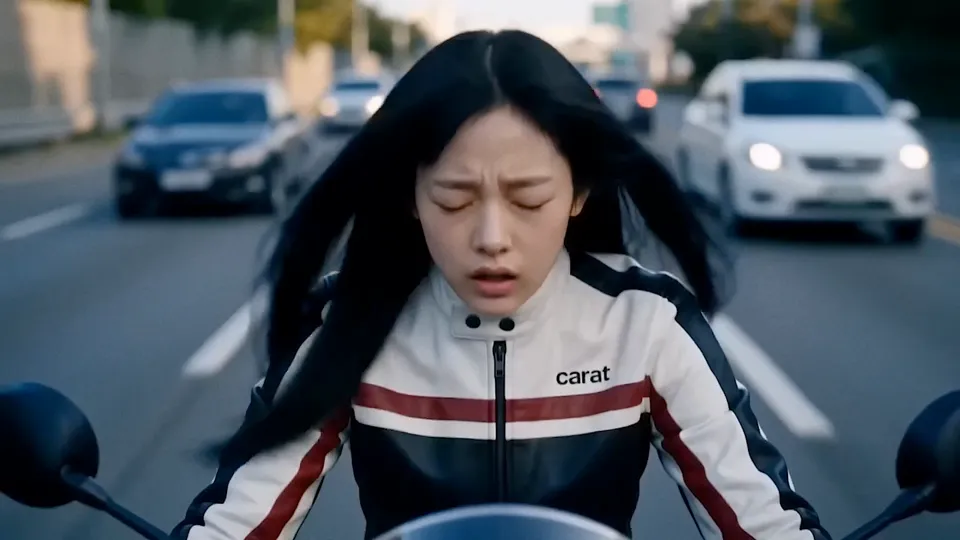
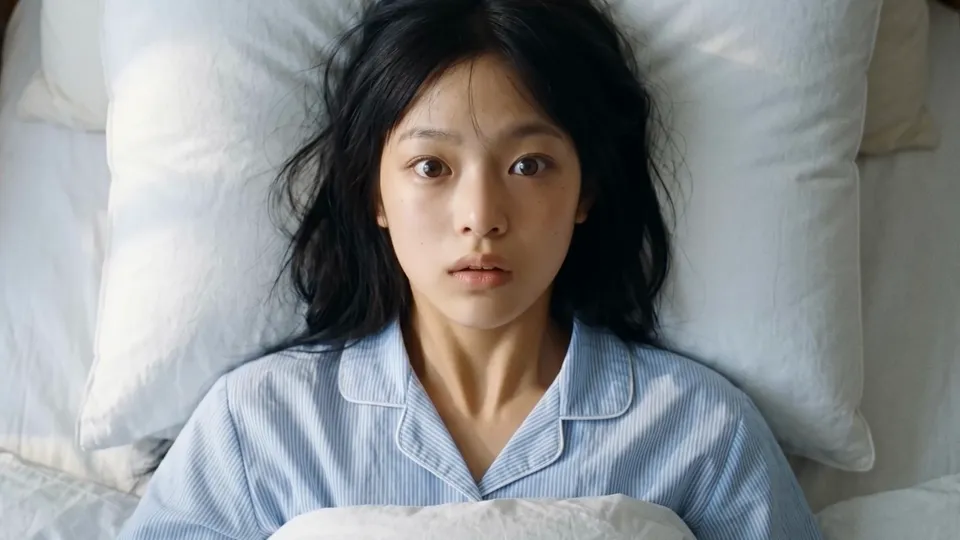
30초 에너지 절약 캠페인 데모
후편집과 마무리
생성한 씬은 이어 붙이고 소리와 자막을 더해야 한 편이 됩니다. 기본 편집은 캐럿AI에서도 할 수 있습니다. 영상의 완성도는 생성보다 편집에서 갈리는 경우가 많아, 일정을 짤 때 후편집 시간을 따로 잡습니다.
다섯 가지 작업
- 컷 잇기와 길이씬을 순서대로 잇고 늘어진 구간을 잘라 길이를 맞춥니다. 30초 영상은 15초 안쪽 씬 두세 개와 엔딩 컷으로 나눕니다.
- 배경음악따로 생성한 음악을 깔고, 배경음악의 드롭 구간에 장면 전환을 맞추면 이음새가 덜 보입니다.
- 내레이션과 자막내레이션은 TTS로 만들고 자막은 편집 단계에서 넣습니다.
- 색감씬마다 다른 색감과 밝기를 맞춥니다. 정교한 컬러 그레이딩은 프리미어 프로, 캡컷 같은 편집 툴을 함께 씁니다.
- 로고 엔딩로고처럼 정확해야 하는 장면은 생성하지 않고 정지 이미지를 영상으로 바꿔 붙입니다. 글자와 로고가 깨질 걱정이 없고 다른 영상에도 그대로 다시 씁니다.
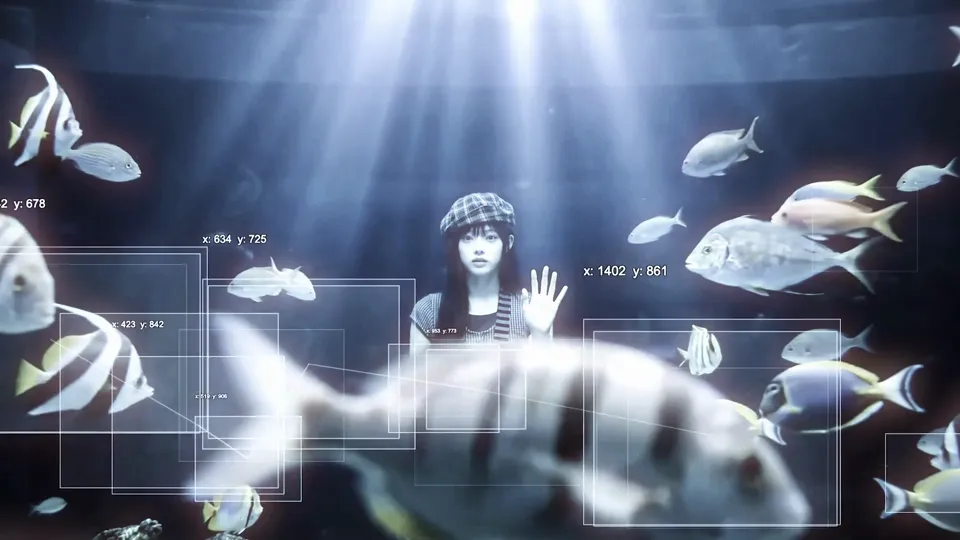
편집에서 더한 장면
사용자별 활용
촬영 장비와 편집 인력 없이 만들 수 있어, 영상이 필요한 직무라면 쓰임이 있습니다.
누가 어디에 쓰나
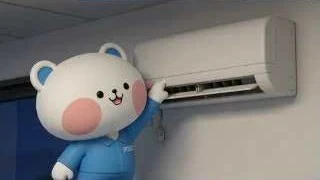
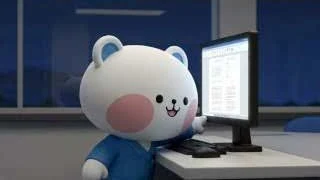
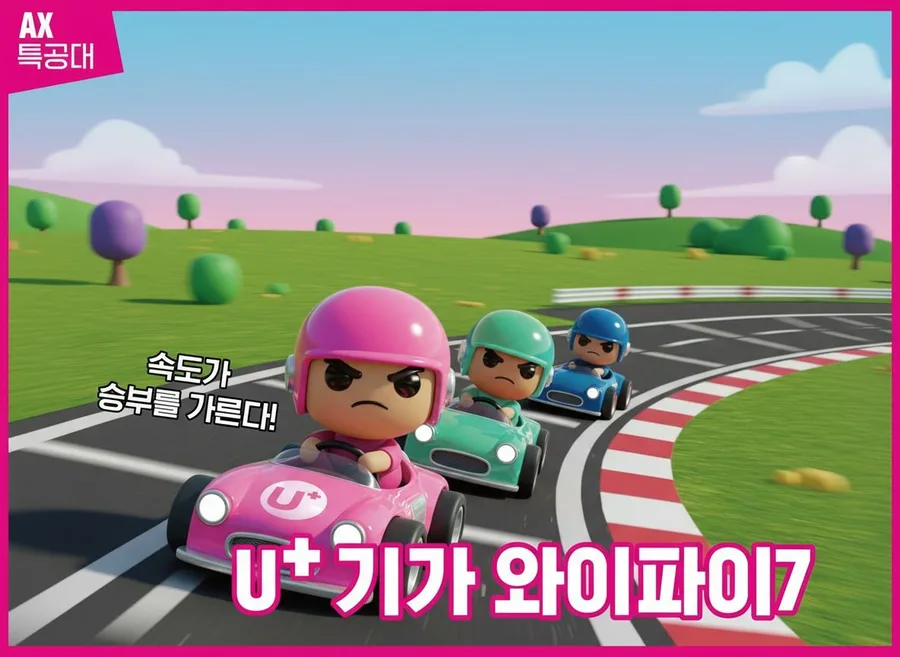
- 마케터제품 리뷰, 프로모션, 광고 소재를 숏폼으로 만듭니다. 이미지 몇 장과 짧은 설명으로 광고 소재를 여러 벌 만들어 비교합니다. LGU+ 마케터들은 캐릭터와 애니메이션으로 광고 영상을 직접 만들었습니다.
- 유튜버·크리에이터쇼츠, 릴스, 틱톡 영상을 촬영 없이 만들고, 찍지 못한 장면을 이미지에서 영상으로 채웁니다. 채널 캐릭터를 캐릭터시트로 만들어 두면 매 편 같은 얼굴로 등장시킬 수 있습니다.
- 출판·콘텐츠 기업책고래 출판사는 그림책 작화를 살려 애니메이션 영상으로 옮겼습니다.
- 교육 기관서강대학교 학생 40명은 이틀짜리 해커톤에서 팀별 영상을 완성했습니다.
- 홍보 담당자기관 마스코트로 캠페인 영상과 쇼츠를 만듭니다. 부산광역시는 마스코트 「부기」 이미지에서 쇼츠까지 직접 만들었습니다.
실제 결과물
자주 묻는 질문
AI 영상 만드는 법, 무엇부터 배우면 되나요?
생성 방식 네 가지(T2V, I2V, 키프레임, R2V)의 차이부터 익힙니다. 방식을 고르면 필요한 준비물이 정해집니다.
AI 영상은 어떻게 생성되나요?
영상 모델은 대량의 영상과 이미지, 설명을 학습해 장면과 움직임의 관계를 익힙니다. 입력한 텍스트나 이미지를 바탕으로 어떤 움직임이 어울릴지 예측해 새 영상을 생성합니다.
사진 한 장으로도 영상을 만들 수 있나요?
I2V로 만들 수 있습니다. 사진을 첫 프레임으로 넣고 원하는 움직임과 카메라 이동을 적으면 그 사진에서 시작하는 영상이 나옵니다.
어떤 모델로 시작하면 좋나요?
R2V를 지원하는 Seedance 2.0, Kling O 시리즈, Gemini Omni가 대표 모델이며, 가이드는 Seedance 2.0을 기준으로 설명합니다.
텍스트 프롬프트만으로 만들면 안 되나요?
만들 수는 있지만 인물 생김새와 구도를 고정하기 어렵습니다. 같은 인물이 여러 컷에 나오는 영상은 캐릭터시트 같은 레퍼런스를 먼저 만드는 편이 생성 횟수가 적습니다.
생성된 영상의 길이를 늘릴 수 있나요?
생성 한 번에 보통 5~15초입니다. 30초 이상은 15초 안쪽 씬으로 나눠 만들고 편집에서 잇습니다.
질문 7개 더 보기
배경음악이나 내레이션도 넣을 수 있나요?
최신 영상 모델은 대사와 효과음을 영상과 함께 만듭니다. 내레이션은 TTS로, 배경음악은 음악 생성 모델로 따로 만들어 편집 단계에서 넣습니다.
영상 비율은 어떻게 정하나요?
올릴 채널에 맞춰 생성 단계에서 정합니다. 쇼츠, 릴스, 틱톡은 세로 9:16, 유튜브 본편과 발표 자료는 가로 16:9가 기본입니다. 나중에 비율을 바꾸면 화면이 잘리므로 처음부터 맞춰 생성합니다.
원하는 결과가 나오지 않으면 어떻게 하나요?
전체를 다시 만들기보다 문제가 된 씬만 다시 생성합니다. 동작이 어색하면 동작 설명을 한 문장으로 줄이고, 인물이 바뀌면 레퍼런스를 다시 넣습니다.
같은 인물이 컷마다 다르게 나오면 어떻게 하나요?
캐릭터시트를 레퍼런스로 넣습니다. 일관성에 강한 이미지 모델로는 나노바나나 프로, Seedream 4.5, Flux 2, GPT Image 1.5가 있습니다.
편집 프로그램을 따로 배워야 하나요?
컷 편집, 음악, 자막, 색감 보정 같은 기본 후편집은 캐럿AI에서도 할 수 있습니다. 정교한 컬러 그레이딩이 필요할 때만 전문 편집 툴을 함께 씁니다.
만든 영상을 광고에 써도 되나요?
결과물이 기존 저작물, 인물, 브랜드와 닮지 않았다면 광고에 쓸 수 있습니다. 서비스마다 허용 범위가 달라 약관을 확인해야 하며, 캐럿은 모든 플랜에서 상업적 이용을 허용합니다.
가이드는 어떻게 받나요?
페이지 위 신청 양식에 이름, 회사명, 업무용 메일을 입력하면 19페이지 PDF를 메일로 보내 드립니다.