이 글을 읽고 나면
✅ AI 캐릭터 일관성이 왜 깨지는지 얼굴과 배경을 나눠 이해할 수 있어요
✅ 8가지 방법 중 지금 작업에 맞는 조합을 고를 수 있어요
✅ 일관성이 깨졌을 때 요청문보다 먼저 확인할 곳을 알게 돼요
첫 컷에서 마음에 드는 인물이 나왔는데 다음 컷에서 얼굴이 달라진 적이 있나요? 광고 시리즈나 짧은 드라마처럼 같은 인물이 여러 번 나오는 작업에서는 AI 캐릭터 일관성이 깨진 컷이 바로 눈에 띄어요. 얼굴만 맞춘다고 끝나지도 않아요. 같은 방이어야 할 배경에서 창문 위치가 바뀌면 컷을 이어 붙이는 순간 어색해져요.
얼굴과 배경을 함께 붙잡는 방법 8가지와, 작업에 맞게 고르는 기준을 정리했어요. 같은 문장만 넣었을 때와 기준 이미지를 함께 넣었을 때 결과가 얼마나 다른지는 AI로 만든 예시 이미지로 보여 드려요.
#AI 캐릭터 일관성은 왜 깨지나요?
이미지·영상 생성 AI는 앞에서 만든 이미지를 기억해 이어 그리지 않고, 요청을 받을 때마다 결과를 새로 만들어요. 같은 문장을 넣어도 얼굴형과 눈매, 머리 모양이 조금씩 달라지는 이유예요.
'갈색 재킷을 입은 30대 남성'이라는 문장에는 수많은 얼굴이 들어맞고, 설명이 막연할수록 AI가 고를 수 있는 범위도 넓어져요. 그래서 일관성을 지키는 방법은 대부분 이 범위를 좁히는 일이에요.
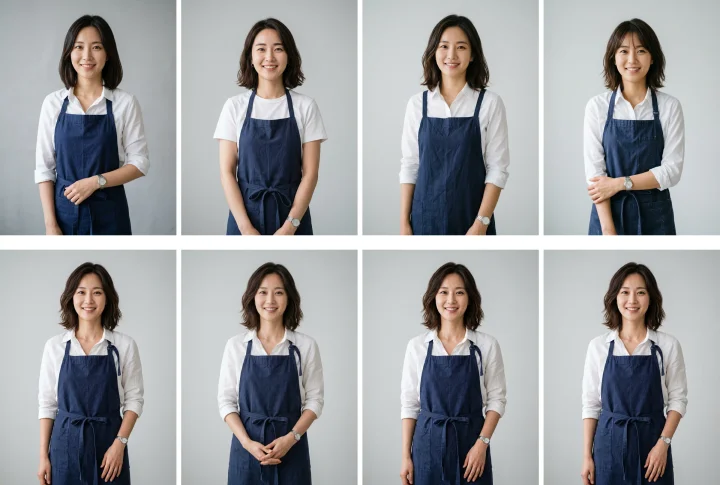
위 예시는 아래 1번 방법의 예문을 영어로 옮기고 흰 셔츠와 회색 배경을 더해 나노바나나 2로 만든 예시예요. 윗줄 네 장은 같은 문장만 넣었는데 앞머리 유무와 머리 길이, 반소매와 긴소매 셔츠, 시계를 찬 손목까지 달라졌어요. 아랫줄은 같은 문장으로 따로 만든 한 장을 기준 이미지로 함께 넣은 결과예요. 네 장 모두 얼굴형과 웨이브, 앞치마 끈을 묶은 모양까지 그대로 남았어요.
#얼굴보다 배경이 더 어려운 이유
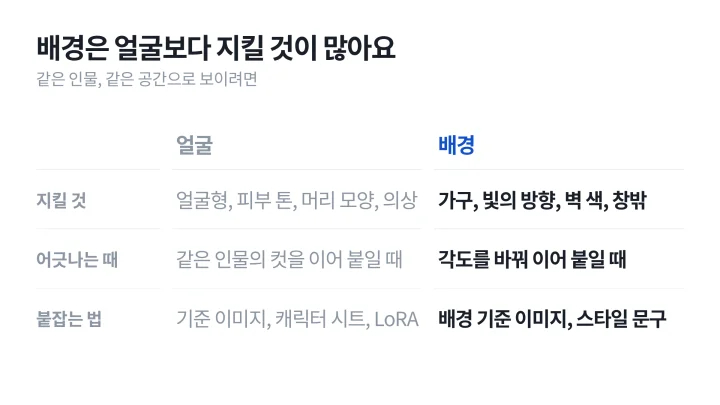
얼굴은 한 사람의 생김새만 지키면 되지만, 배경은 여러 요소가 동시에 그대로 있어야 해요. 카메라 각도가 바뀌어도 창문과 가구, 빛이 들어오는 방향이 같아야 같은 공간으로 보여요. 일관성을 다룬 자료는 대개 얼굴만 설명하지만, 실제 영상에서는 배경이 먼저 깨지는 경우도 많아요.
| 구분 | 얼굴 | 배경(장소) |
|---|---|---|
| 지켜야 할 것 | 얼굴형, 피부 톤, 머리 모양, 의상 | 가구 위치, 빛의 방향, 벽 색, 창밖 풍경, 시간대 |
| 글로만 설명하면 | 비슷하지만 다른 사람이 나와요 | 비슷하지만 다른 방이 나와요 |
| 어긋남이 보이는 순간 | 같은 인물의 컷을 이어 붙일 때 | 같은 공간을 다른 각도로 이어 붙일 때 |
| 붙잡는 방법 | 인물 기준 이미지, 캐릭터 시트, LoRA | 배경 기준 이미지, 공통 스타일 문구 |
#1. 고정 특징을 글로 먼저 정해 두기
모든 방법의 출발점이에요. 컷마다 같아야 하는 특징을 먼저 문장으로 정해 두면 요청문을 누가 쓰든, 몇 번째 컷이든 같은 설명으로 시작할 수 있어요.
- 🎯 붙잡는 것 이름, 나이대, 머리 색과 모양, 의상, 눈에 띄는 표식처럼 컷마다 같아야 하는 특징이에요
- 📌 하는 법 특징을 한 문단으로 적어 두고 모든 요청문 앞쪽에 그대로 붙여요. 컷마다 표현을 바꿔 쓰지 마세요
- 👍 잘 맞는 작업 기준 이미지가 아직 없는 기획 초기, 여러 사람이 요청문을 나눠 쓰는 팀 작업이에요
- ⚠️ 주의할 점 글만으로는 얼굴까지 고정되지 않아요. 같은 설명에 맞는 얼굴이 여러 개라서 다른 방법과 함께 써야 해요
예를 들면 '20대 후반 여성, 어깨에 닿는 흑갈색 단발, 남색 앞치마, 왼쪽 손목의 은색 시계'처럼 적어요. 색과 위치까지 적어 두면 AI가 임의로 채울 빈칸이 그만큼 줄어들어요.
#2. 시드 값 고정하기
시드는 AI가 이미지를 만들기 시작할 때 쓰는 출발점 번호로, 같은 시드와 같은 요청문을 쓰면 비슷한 결과가 나올 가능성이 커져요.
- 🎯 붙잡는 것 구도와 색감, 전체 분위기예요
- 📌 하는 법 마음에 드는 결과의 시드 번호를 확인해 두고 다음 생성에 같은 번호를 넣어요. 미드저니는 요청문 뒤에 --seed 값을 붙이고, 스테이블 디퓨전 계열 도구는 설정 칸에 입력해요
- 👍 잘 맞는 작업 같은 장면에서 표정이나 소품 하나만 바꿔 보는 변형 작업이에요
- ⚠️ 주의할 점 요청문이 크게 바뀌면 결과도 크게 달라져요. 시드 입력 칸이 없는 영상 생성 서비스도 있어요
#3. 인물 기준 이미지를 레퍼런스로 넣기
글로 설명하는 대신 이미지를 보여 주는 방법이에요. 기준이 될 인물 이미지 한 장을 정하고, 새 이미지를 만들 때마다 그 이미지를 참고 자료로 요청문과 함께 넣어요.
- 🎯 붙잡는 것 얼굴과 의상, 그림체예요
- 📌 하는 법 미드저니는 캐릭터 참조 기능을 공식 문서에서 안내해요. 버전에 따라 이름과 명령어가 달라서 쓰는 버전의 문서를 확인해요. 스테이블 디퓨전은 컨트롤넷과 IP-Adapter로 기준 이미지의 특징을 반영해요. 구글 제미나이의 나노바나나처럼 여러 이미지를 합쳐 같은 인물을 표현하는 이미지 모델도 있어요
- 👍 잘 맞는 작업 따로 학습시킬 시간이 없는 광고 시안, 컷 수가 많지 않은 작업이에요
- ⚠️ 주의할 점 기준 이미지의 상태가 결과에 그대로 드러나요. 워터마크가 있으면 결과에도 찍혀 나올 수 있고, 얼굴만 너무 좁게 잘라 넣으면 AI가 세부를 지어내요. 얼굴은 목과 어깨까지 넉넉하게 담긴 선명한 이미지로 준비해요
#4. 캐릭터 시트 만들기
캐릭터 시트는 한 인물을 여러 방향에서 보여 주는 기준 이미지 묶음이에요. 기준 이미지 한 장으로는 정면만 알 수 있어서, 인물이 돌아서거나 다가오는 컷에서 모습이 달라지기 쉬워요.
- 🎯 붙잡는 것 앞모습과 뒷모습, 얼굴 생김새예요
- 📌 하는 법 정면 전신, 뒤돌아선 후면 전신, 정면 얼굴 클로즈업 세 칸으로 구성해요. 의상은 전신 칸에서, 얼굴은 클로즈업 칸에서 잘 보이게 나눠요
- 👍 잘 맞는 작업 같은 인물이 여러 장면에 나오는 시리즈 광고, 숏드라마, 브랜드 캐릭터예요
- ⚠️ 주의할 점 옆모습이 꼭 필요하면 얼굴 칸의 각도를 어중간하게 틀기보다 옆모습 칸을 하나 더 만들어요. 손에 든 소품은 시트에 잘 잡히지 않아서 요청문에 따로 적어요
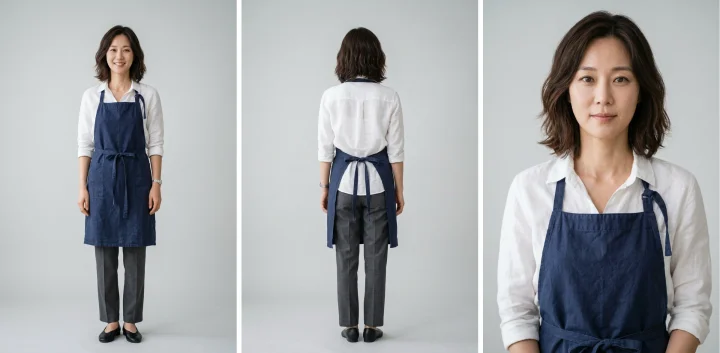
위 예시 시트는 정면 전신을 먼저 만든 뒤, 기준 얼굴 이미지와 정면 전신 두 장을 함께 넣고 후면을 요청해 만들었어요. 시계를 왼쪽 손목에 찼다고 적어 두면 뒤돌아선 칸에서도 시계가 같은 쪽 손목에 남았는지 바로 확인할 수 있어요.
#여러 각도를 이어서 만드는 순서
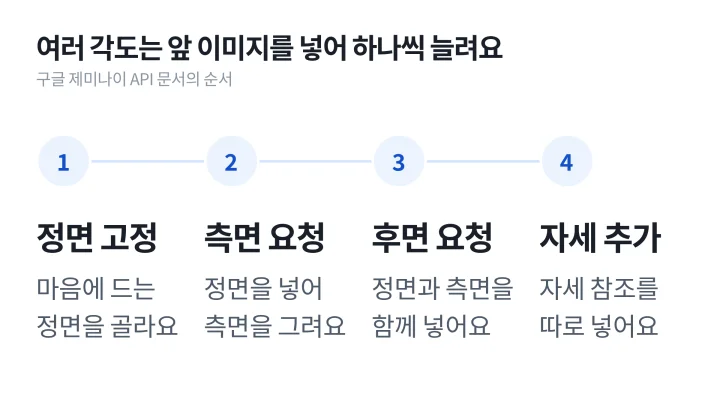
구글 제미나이 API 문서는 캐릭터의 360도 모습을 만들 때 각도를 바꿔 가며 여러 번 요청하고, 앞에서 만든 이미지를 다음 요청에 함께 넣으라고 안내해요. 시트 전체를 한 번에 그리게 하기보다 칸을 하나씩 늘려 가는 방식이라 앞 칸의 얼굴이 다음 칸의 참조 이미지가 돼요.
- 정면 전신을 먼저 만들고 마음에 드는 한 장을 고정해요
- 그 이미지를 넣고 같은 인물의 측면을 요청해요
- 정면과 측면 두 장을 함께 넣고 후면을 요청해요
- 복잡한 자세가 필요하면 그 자세를 담은 참조 이미지를 따로 넣어요
#5. LoRA로 캐릭터 학습시키기
LoRA는 특정 캐릭터의 이미지를 AI 모델에 추가로 학습시킨 작은 확장 파일이에요. 한 번 만들어 두면 불러올 때마다 같은 캐릭터를 다시 그려 내기 쉬워져요.
- 🎯 붙잡는 것 얼굴 생김새예요. 8가지 방법 중 가장 확실하게 고정해요
- 📌 하는 법 같은 캐릭터를 정면, 측면, 여러 표정과 조명으로 담은 이미지를 모아 학습시켜요. 필요한 장수는 도구마다 달라요. 학습이 끝나면 트리거 단어를 요청문에 넣어 불러와요
- 👍 잘 맞는 작업 몇 달 동안 같은 캐릭터를 써야 하는 브랜드 캐릭터, 웹툰, 연재 콘텐츠예요
- ⚠️ 주의할 점 학습 시간과 비용이 들고, 학습을 지원하는 도구에서만 쓸 수 있어요. 트리거 단어에 의상까지 묶으면 나중에 옷을 바꾸기 어려워져요
#LoRA 학습은 이렇게 준비해요
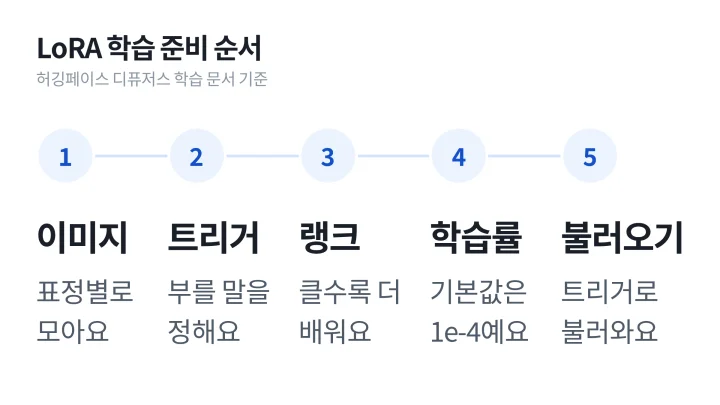
허깅페이스 디퓨저스의 LoRA 학습 문서에 따르면 LoRA는 모델 전체가 아니라 새로 끼워 넣은 적은 수의 가중치만 학습해서, 학습이 빠르고 결과 파일도 수백 MB 수준으로 작아요. 모델 전체를 고치는 드림부스 방식과 함께 쓸 수도 있어요. 드림부스는 적은 수의 이미지를 요청문 속 특별한 단어와 연결해 그 대상을 기억하게 하는 방식이에요.
- 같은 캐릭터를 정면, 측면, 여러 표정과 조명으로 담은 이미지를 모아요
- 이미지마다 설명 문장을 붙이고, 캐릭터를 부를 트리거 단어를 하나 정해요
- 랭크(rank)를 정해요. 랭크가 높을수록 학습하는 값이 많아져요
- 학습률을 정해요. 문서 기본값은 1e-4이고, LoRA에서는 이보다 높게 잡기도 해요
- 학습이 끝나면 요청문에 트리거 단어를 넣어 불러와요
#6. 배경 기준 이미지를 따로 정하기
인물을 고정해도 배경이 바뀌면 같은 장면으로 보이지 않기 때문에, 배경도 인물처럼 기준 이미지가 필요해요.
- 🎯 붙잡는 것 공간의 구조, 빛의 방향, 주요 가구와 소품의 위치예요
- 📌 하는 법 공간 전체가 보이는 넓은 이미지 한 장을 먼저 만들어요. 창문과 문, 광원, 큰 가구가 한 화면에 들어오게 해요. 아직 없는 공간이라면 콘셉트 이미지 한 장으로도 기준을 잡을 수 있어요
- 👍 잘 맞는 작업 한 공간에서 여러 각도로 찍는 대화 장면, 매장이나 사무실처럼 반복해서 나오는 장소예요
- ⚠️ 주의할 점 밤 장면이라도 기준 이미지는 실내 조명이 켜진 밝기로 만들어요. 어두운 배경 이미지에 인물을 넣으면 인물까지 어둡게 나와요
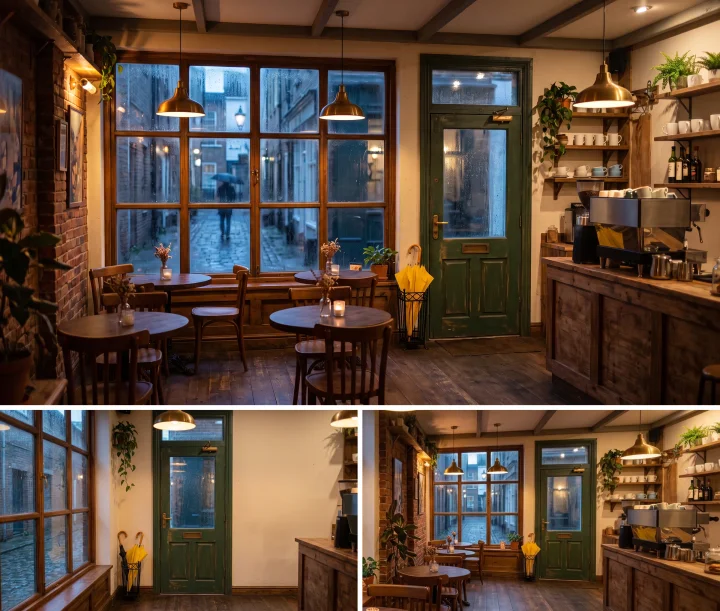
처음 요청한 두 컷은 기준 이미지와 거의 같은 구도로 나왔어요. 카메라를 세울 위치와 화면 가장자리에 걸릴 사물까지 적어 다시 요청하자 그제야 각도가 다른 컷이 나왔어요. 기준 이미지에 있던 커피 머신 상표판은 그 이미지를 넣는 컷마다 따라 나올 수 있어서, 각도를 바꾸기 전에 기준 이미지에서 먼저 지웠어요. 세 장 모두 창이 문 왼쪽에 있고, 노란 우산을 꽂은 우산꽂이는 창과 문 사이에 있어요. 각도를 바꾼 컷을 볼 때는 이런 위치 관계부터 기준 이미지와 맞대 보세요.
#7. 기준 이미지에서 영상을 시작하고 여러 컷을 함께 만들기
영상에서는 첫 화면이 일관성을 좌우해요. 글로만 영상을 만들면 AI가 컷마다 인물과 공간을 처음부터 새로 해석하기 때문이에요.
- 🎯 붙잡는 것 컷과 컷 사이의 인물, 공간, 조명이에요
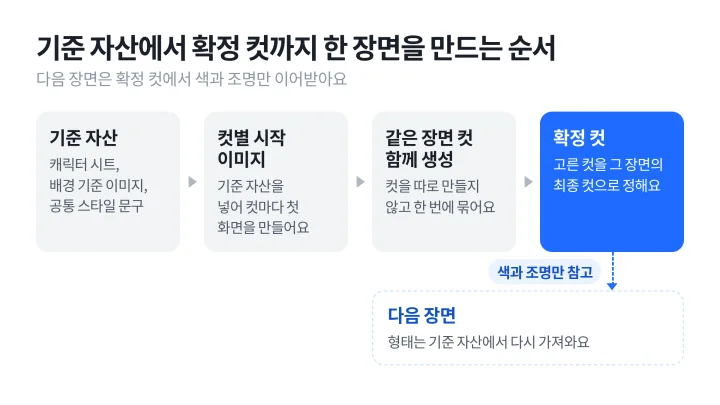
- 📌 하는 법 앞에서 정한 인물과 배경 기준 이미지로 컷의 시작 이미지를 먼저 만들고, 그 이미지에서 영상을 생성해요. 요청문에는 외모 설명을 반복하기보다 인물과 카메라의 움직임만 적어요. 여러 컷을 한 번에 묶어 생성하는 기능이 있다면 같은 장면의 컷은 따로 만들지 말고 함께 만들어요
- 👍 잘 맞는 작업 한 장면을 여러 컷으로 나눠 보여 주는 광고, 짧은 이야기 영상이에요
- ⚠️ 주의할 점 이미 만든 영상에서 캡처한 프레임을 기준 이미지로 다시 넣으면 화질이 떨어질 수 있어요. 압축된 화면을 다시 압축하는 셈이라 반복할수록 흐려져요
#Veo 3.1에는 인물을 유지하는 기능이 세 가지 있어요
영상 모델도 컷 사이를 잇는 기능을 따로 두는 경우가 많아요. 구글 Veo 문서를 예로 들면 같은 인물을 유지하는 기능이 세 가지로 나뉘어 있어요.
- 📌 참조 이미지는 인물이나 캐릭터, 제품 이미지를 최대 3장까지 넣어 결과 영상에서 생김새를 지키게 해요. Veo 3.1 모델에서만 쓸 수 있어요
- 📌 첫·끝 프레임은 영상의 시작 화면과 마지막 화면을 지정하면 모델이 그 사이를 채워 주는 기능이에요. 앞 컷의 마지막 화면을 다음 컷의 시작 화면으로 넘길 때 쓰기 좋아요
- 📌 영상 연장은 Veo로 만든 영상을 7초씩 최대 20번 이어 붙여 148초까지 늘려요
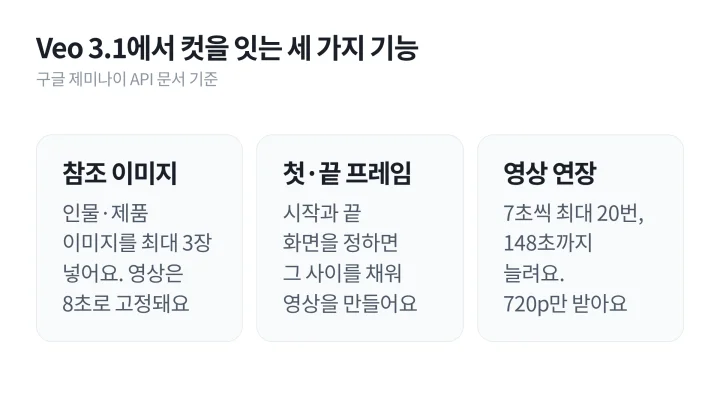
조건도 함께 봐야 해요. 참조 이미지를 쓰면 영상 길이가 8초로 고정되고, 연장은 720p 영상만 받으며, 만든 영상은 2일 동안만 보관돼 그 안에 연장해야 해요. 구글 영상 생성 안내 문서는 인물 일관성과 대화식 수정을 강점으로 든 Gemini Omni Flash를 기본 모델로 권하고, 장면 연장이나 마지막 프레임 지정이 필요할 때 Veo 3.1을 쓰라고 해요.
다만 Gemini API 문서는 Veo 3.1 프리뷰 모델(veo-3.1-generate-preview 등)을 2026년 10월 22일 종료한다고 공지하고, Gemini Omni Flash(gemini-omni-1.1-flash)로 옮기라고 안내해요. API로 같은 흐름을 이어 쓰려면 아래 대화형 편집 방식도 함께 봐 두세요.
#8. 공통 스타일 문구와 샷 리스트로 묶기
인물과 배경이 같아도 색감과 조명이 컷마다 다르면 다른 영상처럼 보여요. 마지막 방법으로 영상 전체에 공통으로 쓰는 기준을 문서 한 장으로 만들어 둬요.
- 🎯 붙잡는 것 색감, 조명, 질감, 컷 구성이에요
- 📌 하는 법 영상 전체의 분위기를 한 줄로 정해 모든 요청문 끝에 똑같이 붙여요. 만들 컷을 순서대로 적은 샷 리스트에 컷마다 등장인물, 장소, 구도를 적어 두면 요청문을 같은 틀로 쓸 수 있어요
- 👍 잘 맞는 작업 여러 사람이 나눠 만드는 영상, 같은 형식으로 반복 제작하는 시리즈예요
- ⚠️ 주의할 점 스타일 문구는 한 번 정하면 중간에 바꾸지 않아요. 바꿔야 한다면 이미 만든 컷도 바꾼 문구로 다시 만들어요
아래처럼 기획표 한 장을 채워 두고 각 컷의 요청문에 해당 칸을 그대로 옮기면 돼요. 예시는 비 오는 저녁 카페를 배경으로 한 가상 장면이에요.
| 구성 요소 | 적는 내용 | 예시 |
|---|---|---|
| 인물 | 나이대, 머리, 의상, 표식 | 30대 카페 주인, 짧은 흑발, 남색 앞치마 |
| 장소 | 공간, 주요 가구, 광원, 시간대 | 골목 카페, 문 옆 우산꽂이, 따뜻한 실내 조명, 비 오는 저녁 |
| 소품 | 색, 재질, 누가 어떻게 드는지 | 노란 우산, 검은 곡선 손잡이, 주인이 오른손에 든 상태 |
| 공통 스타일 | 모든 컷에 붙일 색감과 조명 | 따뜻한 실내와 푸른 바깥의 대비, 부드러운 조명 |
| 컷 | 번호, 길이, 구도, 행동 | S1, 4초, 넓은 구도, 문을 닫는 주인 |
#어떤 방법부터 써야 하나요?
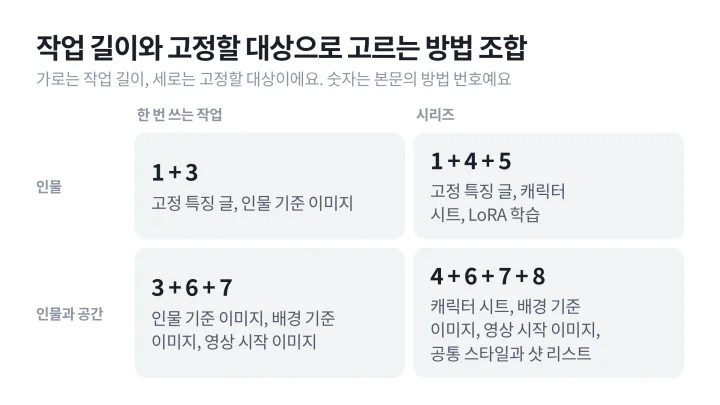
정답은 없어요. 작업이 얼마나 길게 이어지는지, 무엇을 고정해야 하는지에 따라 맞는 조합이 달라요. 대부분의 작업은 방법 하나보다 두세 가지를 겹쳐 쓸 때 안정적이에요.
| 방법 | 준비 부담 | 붙잡는 범위 | 잘 맞는 작업 |
|---|---|---|---|
| 1. 고정 특징 글 | 낮음 | 의상, 표식 | 모든 작업의 기본 |
| 2. 시드 고정 | 낮음 | 구도, 분위기 | 같은 장면의 변형 |
| 3. 인물 기준 이미지 | 중간 | 얼굴, 의상 | 한 번 쓰는 광고 시안 |
| 4. 캐릭터 시트 | 중간 | 앞뒤 모습, 얼굴 | 시리즈 광고, 숏드라마 |
| 5. LoRA 학습 | 높음 | 얼굴 | 오래 쓰는 브랜드 캐릭터 |
| 6. 배경 기준 이미지 | 중간 | 공간, 빛 | 한 장소의 여러 컷 |
| 7. 기준 이미지에서 영상 시작 | 중간 | 컷 사이 연결 | 여러 컷 영상 |
| 8. 공통 스타일과 샷 리스트 | 낮음 | 색감, 컷 구성 | 팀 작업, 반복 제작 |
- 👍 이미지 한두 장이 필요한 작업이라면 1번과 3번으로 충분한 경우가 많아요
- 👍 같은 인물이 여러 장면에 나오는 영상이라면 4번, 6번, 7번을 함께 써요
- 👎 시드 고정만으로 시리즈 전체를 맞추려 하면 요청문이 바뀌는 순간 인물이 달라져요
- 👎 기획이 굳기 전에 LoRA부터 만들면 설정이 바뀔 때마다 다시 학습해야 해요
#도구마다 참조 기능은 무엇이 다른가요?
AI 캐릭터 일관성을 지키는 기본 원리는 도구가 달라도 같아요. 참조 이미지를 함께 넣어 AI가 고를 범위를 좁혀요. 다만 한 번에 넣을 수 있는 장수와 세기를 조절하는 방식은 도구마다 달라서 공식 문서 기준으로 표에 모았어요.
| 도구 | 기능 | 넣을 수 있는 이미지 | 세기 조절 |
|---|---|---|---|
| 미드저니 V7 | 옴니 레퍼런스(--oref) | 인물·사물 이미지, 두 인물은 한 장에 함께 또는 나란히 | --ow, 기본값 100 |
| 미드저니 V8.2 | 편집 모델(테스트 중) | 이미지 참조 4장까지, 부분 수정과 캔버스 확장 | 요청문으로 지시 |
| 제미나이 3 Pro Image | 다중 참조 | 인물 5장까지 충실히 반영, 전체 14장까지 | 요청문으로 지시 |
| 나노바나나 2.1 | 다중 참조 | 인물 4명, 사물 10개까지 | 요청문으로 지시 |
| 스테이블 디퓨전 | IP-Adapter | 기준 이미지, 얼굴 전용 FaceID 변형 | scale 1.0이 최대, 0.5가 대체로 균형 |
#미드저니는 옴니 레퍼런스에서 V8.2 편집 모델로 옮겨 가는 중이에요
미드저니는 2025년 5월 V7용 옴니 레퍼런스를 내놓으면서 V6의 캐릭터 참조(--cref)가 하던 일을 대부분 대신할 수 있다고 공지했어요. 사람뿐 아니라 사물과 탈것, 사람이 아닌 생물에도 쓸 수 있고, 캐릭터가 칼을 들게 하려면 칼 이미지를 넣더라도 요청문에 '칼을 든 캐릭터'라고 적어야 한다고 설명해요.
2026년 6월 11일 V8.1이 기본 모델이 됐을 때는 V8용 옴니 레퍼런스가 아직 학습 중이었고, 7월 24일 V8.2가 나온 뒤 8월 27일에는 V8.2 편집 모델의 테스트가 시작됐어요. 이 모델은 옴니 레퍼런스를 대신해 이미지를 4장까지 함께 참조하고, 글로 지시해 이미지를 고치거나 특정 부분만 다시 그리고 캔버스를 넓힐 수 있어요.
미드저니는 9월 24일 업데이트에서 부분 수정을 하면 선택한 픽셀만 바뀌어서, 같은 이미지를 여러 번 고쳐도 화질이 떨어지지 않게 됐다고 밝혔어요. 얼굴은 그대로 두고 옷이나 소품만 바꾸는 작업에 잘 맞는 기능이에요. 다만 아직 테스트 단계라 결과가 고르지 않으면 V7 옴니 레퍼런스와 번갈아 시험해 보세요.
#제미나이는 이미지 모델마다 참조 한도가 달라요
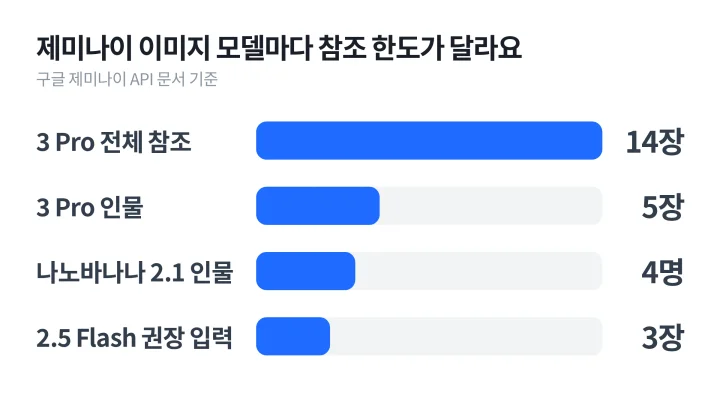
구글 제미나이 API 이미지 생성 문서는 모델별 참조 한도를 따로 적어 두었습니다. 제미나이 3 Pro Image는 인물 이미지 5장까지 충실하게 반영하고 전체 14장까지 섞을 수 있으며, 나노바나나 2.1은 한 작업에서 인물 4명과 사물 10개까지 모습을 그대로 유지한다고 안내해요. 이전 세대인 제미나이 2.5 Flash Image는 입력 이미지가 3장 이하일 때 결과가 가장 좋다고 적혀 있어요.
#스테이블 디퓨전은 IP-Adapter를 붙여요
스테이블 디퓨전 계열은 IP-Adapter라는 추가 모듈로 기준 이미지를 반영해요. 디퓨저스 문서 기준으로 IP-Adapter 파일은 대개 100MB 안팎으로 가볍고, 모델을 새로 학습하지 않고도 붙였다 뗄 수 있어요. 기준 이미지의 세부가 중요하면 Plus 변형을, 얼굴 생김새를 따로 지켜야 하면 FaceID 변형을 고르라고 권해요.
#참조 세기는 얼마로 두나요?
참조 세기는 기준 이미지를 얼마나 그대로 따를지 정하는 값이에요. 올리면 얼굴과 옷이 잘 남는 대신 요청문 속 자세나 그림체가 덜 반영되고, 내리면 반대로 요청문이 더 많이 반영돼요.
- 📌 미드저니 옴니 레퍼런스의 --ow는 0부터 1000까지 쓸 수 있고 기본값은 100이에요. 사진을 애니메이션 그림체로 바꾸려면 25 정도로 낮추고, 얼굴이나 옷을 꼭 남겨야 하면 400 정도까지 올려요. 스타일라이즈 값이 아주 높지 않다면 400을 넘기지 않아야 결과가 안정적이라고 안내해요
- 📌 --stylize와 --exp 값을 높이면 옴니 레퍼런스의 영향이 그만큼 약해져요. 이 두 값을 높였다면 --ow도 함께 올려야 기준이 유지돼요
- 📌 IP-Adapter는 scale 1.0이 기준 이미지를 최대로 반영하고, 0.5가 대체로 글과 이미지의 균형점이에요
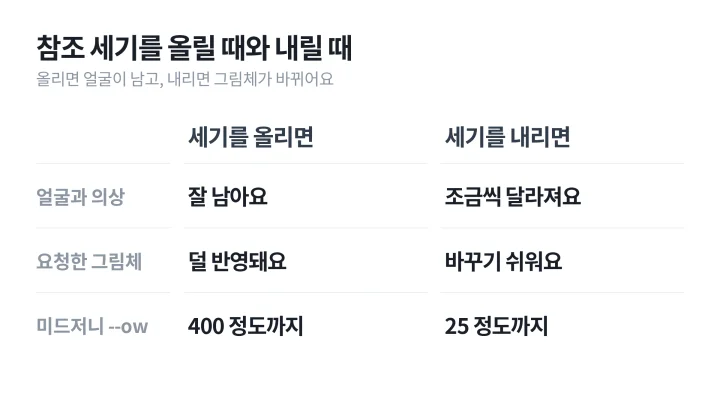
처음에는 기본값에서 시작해 얼굴이 흔들리면 올리고, 요청한 자세나 그림체가 반영되지 않으면 내리는 식으로 한 단계씩 조정해요. 세기와 요청문을 같이 바꾸면 어느 쪽이 효과가 있었는지 가리기 어려워요.
#인물이 여럿이면 기준 이미지는 어떻게 넣나요?
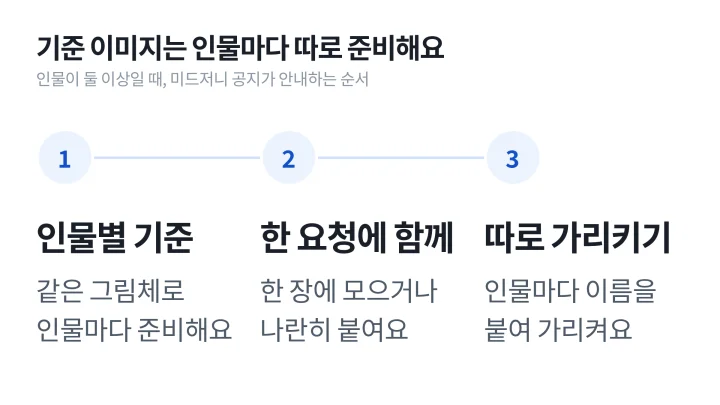
인물이 둘 이상이면 기준 이미지도 인물마다 따로 있어야 해요. 미드저니 공지는 두 인물을 한 장에 함께 담거나 두 장을 나란히 붙인 이미지를 넣고, 요청문에서 두 인물을 각각 가리키라고 해요. 제미나이 이미지 모델은 앞의 표처럼 한 번에 생김새를 지킬 수 있는 인물 수에 한도가 있어서, 등장인물이 그보다 많은 장면은 나눠 만든 뒤 합치세요.
스테이블 디퓨전에서는 IP-Adapter를 여러 개 겹쳐 쓸 수 있어요. 디퓨저스 문서는 얼굴용 IP-Adapter로 인물을 고정하고 Plus 변형으로 그림체를 입히는 조합을 예로 들어요.
#영상을 대화로 고칠 때 인물은 어떻게 유지하나요?
구글이 Veo 3.1 대신 쓰라고 안내하는 Gemini Omni Flash는 영상을 한 번 만든 뒤 말로 고쳐 가는 모델이에요. Gemini Omni Flash 문서는 앞 결과를 previous_interaction_id로 이어받아 영상을 다시 올리지 않고 고칠 수 있다고 설명해요. 다만 요청을 어떻게 적느냐에 따라 바꾸라고 하지 않은 인물까지 달라질 수 있어서 쓰는 법을 알아 둬야 해요.
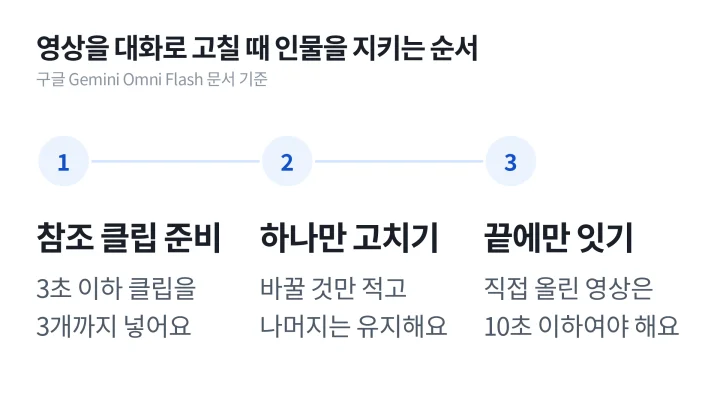
- 📌 바꿀 것 하나만 적고 끝에 'Keep everything else the same(나머지는 그대로 유지)'을 붙여요. 문서가 시각적 일관성을 지키는 방법으로 직접 권하는 문장이에요
- 📌 영상 참조는 3초 이하 클립을 3개까지 넣을 수 있어요. 문서는 이 기능이 인물의 생김새를 지키는 데 가장 잘 맞는다고 적었어요. 참조 영상에 든 소리는 쓰이지 않아요
- 📌 이어 붙이기는 영상의 끝에만 돼요. 앞에 덧붙이거나 중간을 늘릴 수 없어서 컷 순서를 먼저 정하고 뒤로 이어 가야 해요
- 📌 직접 올린 영상을 고치거나 늘리려면 10초 이하여야 해요. 모델이 만든 영상을 대화형 편집으로 이어서 늘리는 경우는 이 제한을 받지 않아요
- 📌 문서에 따르면 이 모델은 영어만 완전히 지원하고, 다른 언어는 아직 평가 전이에요. 인물을 가리키는 핵심 문장은 영어로도 함께 적어 두면 모델이 잘못 알아듣는 일이 줄어요
대사가 있는 장면은 조건이 하나 더 붙어요. 직접 올린 영상에서 누군가 말하고 있으면 대사를 더해 늘릴 수 없고, 인물이 말없이 있거나 모델이 만든 영상을 대화형 편집으로 이어 갈 때만 대사를 넣을 수 있어요. 대사 장면이 많은 작업이라면 처음부터 모델로 만든 영상을 이어 가는 쪽으로 순서를 잡으세요.
장면을 길게 이을 때도 정해진 방식이 있어요. 문서에 따르면 한 번에 10초씩, 전체 40초까지 늘릴 수 있고, 원래 영상의 마지막 10초를 참고해 인물과 움직임, 소리를 이어 가요. 이음매를 매끄럽게 하려고 모델이 입력 영상의 마지막 몇 프레임을 고칠 수 있으니, 꼭 남겨야 하는 컷은 끝부분에 두지 마세요. 참조로 넣은 영상은 요청문에서 <VIDEO_REF_0> 같은 태그로 가리킬 수 있어요.
#LoRA를 직접 학습하려면 그래픽카드 메모리가 얼마나 필요한가요?
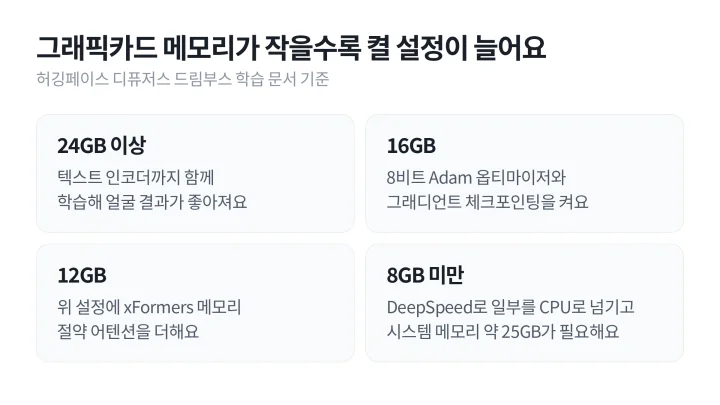
앞에서 본 LoRA나 드림부스를 직접 학습하려면 그래픽카드 메모리(VRAM)부터 확인해야 해요. 허깅페이스 디퓨저스의 드림부스 학습 문서는 메모리 크기마다 켜야 할 설정을 따로 적어 두었습니다.
| 그래픽카드 메모리 | 문서가 안내하는 설정 |
|---|---|
| 24GB 이상 | 텍스트 인코더까지 함께 학습할 수 있고, 특히 얼굴 결과가 좋아진다고 안내 |
| 16GB | 8비트 Adam 옵티마이저와 그래디언트 체크포인팅을 켬 |
| 12GB | 위 설정에 xFormers 메모리 절약 어텐션을 더함 |
| 8GB 미만 | DeepSpeed로 일부를 CPU로 넘기고, 대신 시스템 메모리가 약 25GB 필요 |
문서의 예시 명령은 해상도 512, 학습률 5e-6, 학습 400단계로 잡혀 있어요. 문서는 드림부스가 학습 설정에 민감해 과적합되기 쉽다고 먼저 경고해요. 같은 부류의 이미지를 모델이 스스로 만들어 함께 학습하는 사전 보존 손실(prior preservation loss)을 켜면 모델이 그 부류에 대해 원래 알던 것을 잃지 않으면서 새로운 구도도 만들기 쉬워진다고 설명해요.
장비가 모자라면 LoRA만 학습하는 쪽이 현실적이에요. LoRA 학습 문서는 새로 끼워 넣은 가중치만 학습해서 더 빠르고 메모리를 덜 쓴다고 설명하고, 드림부스와 묶어 학습 시간을 줄이는 방법도 함께 소개해요.
#도구를 바꾸면 캐릭터를 다시 만들어야 하나요?
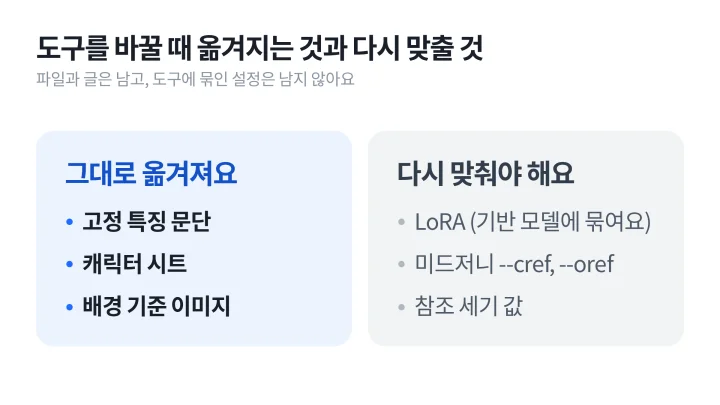
무엇으로 일관성을 잡았는지에 따라 달라요. 고정 특징 문단과 캐릭터 시트, 배경 기준 이미지는 글과 이미지 파일이라 다른 도구에서도 참조 이미지와 요청문으로 다시 넣을 수 있지만, 도구 안에 묶인 설정은 함께 옮길 수 없어요.
- 👎 LoRA는 학습할 때 정한 기반 모델 위에 덧붙이는 가중치예요. 디퓨저스도 스테이블 디퓨전 XL용 LoRA는 별도 학습 스크립트로 나눠 두었고, 불러올 때는 학습에 쓴 기반 모델에 붙여요
- 👎 미드저니의 캐릭터 참조(--cref)는 V6용, 옴니 레퍼런스(--oref)는 V7용으로 공지돼 있어서 버전을 바꾸면 명령과 세기 값을 다시 맞춰야 해요
- 👍 캐릭터 시트와 고정 특징 문단은 어느 도구로 옮겨도 그대로 쓸 수 있어요
오래 쓸 캐릭터라면 도구 설정보다 시트와 문단을 원본으로 보관해 두세요. 도구를 옮길 때는 시트를 참조 이미지로 넣어 몇 컷을 시험해 보고, 얼굴이 달라지는 컷에서만 참조 세기를 조정하면 처음부터 다시 만들 일이 줄어들어요.
#기준 이미지는 어떤 비율과 크기로 만드나요?
영상의 시작 이미지로 쓸 컷은 영상 비율에 맞춰 만들어야 잘리는 부분이 없어요. Gemini Omni Flash와 Veo 3.1이 받는 영상 비율은 16:9 가로와 9:16 세로 두 가지이고, Gemini API 이미지 생성 문서의 표를 보면 같은 1K 해상도라도 비율마다 실제 크기가 달라요.
| 용도 | 비율 | 1K 크기 | 2K 크기 |
|---|---|---|---|
| 가로 영상 시작 이미지 | 16:9 | 1376×768 | 2752×1536 |
| 세로 영상 시작 이미지 | 9:16 | 768×1376 | 1536×2752 |
| 세 칸 캐릭터 시트 | 3:2 | 1264×848 | 2528×1696 |
| 얼굴 클로즈업 기준 | 1:1 | 1024×1024 | 2048×2048 |
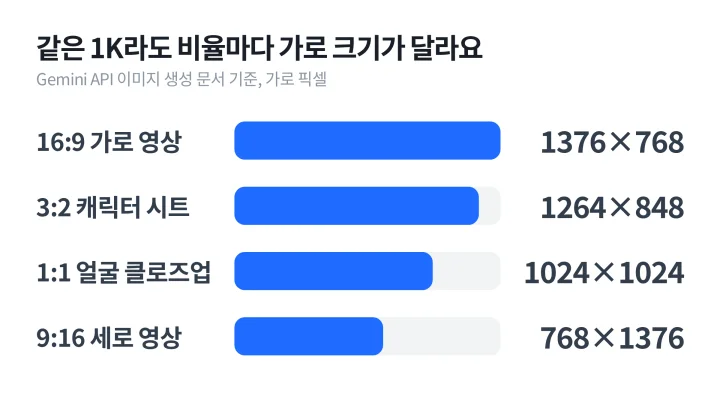
Omni Flash 문서는 이미지에서 영상을 만들 때 해상도가 높은 이미지를 쓰고 움직임을 구체적으로 적으라고 권해요. 얼굴 기준 이미지는 2K로 만들어 두면 시작 이미지로 줄여 쓸 때도 눈매와 머리선이 뭉개지지 않아요. 같은 비율에서 1K를 2K로 올리면 이미지 한 장에 드는 토큰도 1,120개에서 1,680개로 늘어나니, 시안 단계는 1K로 뽑고 확정한 기준만 2K로 다시 만드는 순서가 경제적이에요.
#실제 인물 사진으로 캐릭터를 만들어도 되나요?
도구가 기능 자체를 막아 둔 경우가 많고, 막지 않더라도 정책 조건이 붙어요. 구글 생성형 AI 금지 사용 정책(2024년 12월 17일 개정)은 속일 목적으로 밝히지 않고 실존 인물을 사칭하는 것과, 법이 요구하는 동의 없이 개인정보나 생체 정보를 쓰는 것을 금지해요.
- ⚠️ Gemini Omni Flash는 알아볼 수 있는 특정 인물이 담긴 이미지를 올려 고치는 기능을 지원하지 않아요
- ⚠️ Veo 3.1은 이미지에서 영상을 만들거나 참조 이미지를 쓸 때 사람 생성 옵션을 성인만 허용하는 allow_adult 하나로 제한하고, EU·영국·스위스·중동·북아프리카 지역에서는 모든 방식에서 allow_adult만 쓸 수 있어요
국내에서는 2026년 1월 22일 시행된 인공지능 발전과 신뢰 기반 조성 등에 관한 기본법 제31조 제3항이, 인공지능사업자가 실제와 구분하기 어려운 가상의 이미지나 영상을 제공할 때 AI로 생성했다는 사실을 이용자가 명확하게 알 수 있게 고지하거나 표시하도록 정하고 있어요. 실존 인물을 바탕으로 실제 사람처럼 만든 캐릭터를 광고에 쓰려면 이 표시 의무와 함께 그 인물의 동의를 받았는지부터 확인해야 해요.
처음부터 가상의 인물로 기준 이미지를 만들면 이런 제한을 대부분 피할 수 있고, 앞에서 본 AI 캐릭터 일관성 방법도 그대로 쓸 수 있어요. Omni Flash로 만든 영상에는 모두 눈에 보이지 않는 SynthID 워터마크가 들어가서 나중에 생성 여부를 확인할 수 있어요.
#의상이나 그림체만 바꾸고 얼굴은 그대로 둘 수 있나요?
캐릭터를 정한 뒤에도 계절마다 옷을 바꾸거나 같은 인물을 일러스트로 다시 그려야 할 때가 있어요. Gemini API 이미지 생성 문서는 원본 이미지를 넣고 바꿀 부분만 말로 지정하는 편집 방법을 따로 정리해 두었어요. 그중 얼굴을 지키면서 바꿀 때 쓸 만한 방법은 네 가지예요.
- 📌 부분 수정은 '파란 소파만 갈색 가죽 소파로'처럼 바꿀 대상 하나만 적어 나머지를 그대로 두는 방식이에요. 의상이나 머리 색만 바꿀 때 써요
- 📌 세부 보존은 얼굴이나 로고처럼 꼭 남아야 하는 부분의 생김새를 수정 요청 안에 자세히 묘사하는 방식이에요. 문서는 이렇게 해야 편집하면서도 중요한 세부가 그대로 남는다고 적었어요
- 📌 스타일 변환은 같은 장면을 다른 그림체로 다시 그리게 하는 방식이에요. 미드저니 공지는 --ow를 낮춰 그림체를 바꿀 때 지키고 싶은 특징을 요청문에 오히려 더 자세히 적으라고 권해요. 예시로 든 문장도 '금발에 빨간 멜빵을 한 애니메이션 여성'처럼 머리 색과 의상을 하나하나 짚어요
- 📌 스케치 완성은 대충 그린 그림을 넣고 완성된 이미지로 다듬게 하는 방식이라, 일러스트나 3D 캐릭터의 자세를 먼저 잡을 때 쓸 수 있어요
어느 방법이든 한 번에 하나만 바꾸세요. 옷과 그림체를 같은 요청에서 바꾸면 얼굴까지 달라지기 쉽고, 달라졌을 때 어느 지시 때문인지 가리기 어려워요. 바꾼 결과가 마음에 들면 그 이미지를 새 의상의 기준 이미지로 시트에 한 칸 더해 두세요.
#같은 캐릭터로 컷을 많이 뽑을 때는 요청을 어떻게 보내나요?
광고 소재처럼 같은 인물로 수십 장을 뽑아야 하면 요청을 모아서 보내는 방식이 있어요. 구글 문서는 이미지 생성을 Batch API로도 돌릴 수 있고, 처리 한도가 높아지는 대신 결과가 나오기까지 최대 24시간이 걸린다고 적어 두었어요. Gemini API 요금표에 따르면 Batch는 표준 가격의 절반이에요.
| 구분 | 표준 요청 | Batch 요청 |
|---|---|---|
| 가격 | 요금표 정가 | 정가의 50% |
| 결과 받는 시간 | 바로 | 최대 24시간 |
| 잘 맞는 단계 | 기준 이미지를 정하는 시안 단계 | 기준이 확정된 뒤 대량 변형 |
모델도 함께 골라야 해요. 나노바나나 2 Lite는 문서가 가장 빠르고 싼 이미지 모델로 소개하지만, 여러 참조 이미지 입력이나 연속 편집에는 맞춰져 있지 않아서, 캐릭터 시트를 여러 장 넣어야 하는 작업은 나노바나나 2.1이나 제미나이 3 Pro Image로 보내세요. 요금표를 보면 1K 이미지는 나노바나나 2.1도 한 장 0.0336달러라 Lite와 값이 같아요.
#일관성이 깨졌을 때 무엇부터 확인하나요?
여러 장면이 이어지는 영상을 만들 때 반복해서 막히는 지점을 정리했어요. 요청문을 고치기 전에 아래부터 보면 원인을 빨리 찾을 수 있어요.
- 🔍 기준 이미지가 실제로 들어갔는지 봐요. 인물이 갑자기 다른 그림체로 바뀌었을 때, 그림체 문제처럼 보여도 실제 원인은 기준 이미지 누락인 경우가 있었어요
- 🔍 기준 이미지가 없는 인물이 있는지 봐요. 시트가 없는 인물은 다른 인물의 옷과 외형을 물려받아 나올 수 있어요. 등장인물 전원의 기준 이미지를 같은 그림체로 맞춰요
- 🔍 영상 캡처를 기준으로 쓰지 않았는지 봐요. 캡처한 프레임이나 그 캡처를 고친 이미지는 화질 저하를 그대로 물려받아요. 처음부터 생성한 이미지나 따로 정리한 시트가 안전해요
- 🔍 소품이 혼자 화면을 차지하지 않았는지 봐요. 일관성 때문에 소품 기준 이미지를 넣으면 소품만 크게 보여 주는 컷이 끼어들 수 있어요. 요청문에 '인물이 손에 든 상태로 같은 화면에서만'처럼 조건을 걸어요
- 🔍 하나만 바꿨는데 다른 것도 바뀌지 않았는지 봐요. 머리 색만 바꿨더니 머릿결까지 달라지는 식이에요. 바꿀 것 옆에 그대로 둘 것도 함께 적어요
- 🔍 같은 인물의 두 모습을 한 번에 넣지 않았는지 봐요. 평상복과 예복처럼 두 모습을 함께 넣으면 한쪽이 모든 컷을 차지할 수 있어요. 영상 하나에는 한 모습만 넣으세요
- 🔍 분위기를 글로만 바꾸려 하지 않았는지 봐요. '더 화려하게'처럼 표현만 세게 써도 인상은 잘 바뀌지 않았어요. 결과가 밋밋하면 요청문보다 기준 이미지를 바꿔 보세요
한 번에 하나씩만 바꿔요. 여러 조건을 동시에 고치면 결과가 나아져도 무엇이 효과가 있었는지 알 수 없어요.
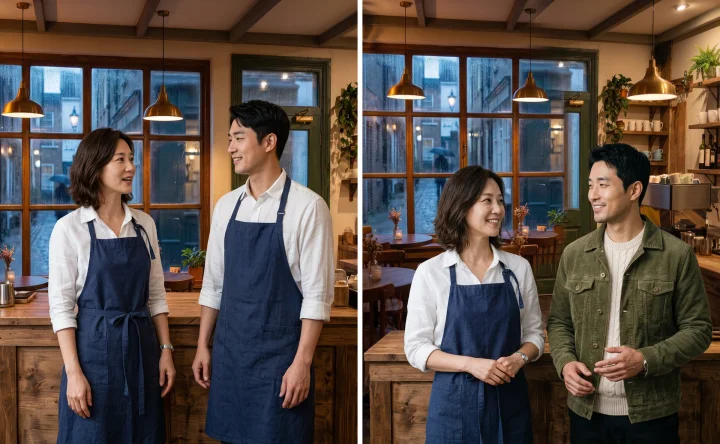
오른쪽 컷에는 여자, 남자, 카페 기준 이미지 세 장을 함께 넣고, 요청문에 첫째 이미지는 여자, 둘째는 남자, 셋째는 배경이라고 순서대로 적었어요. 이미지마다 지킬 것도 얼굴, 머리, 옷으로 나눠 적었어요. 왼쪽은 남자 기준 이미지를 뺀 컷이라 남자의 얼굴도 오른쪽과 달라요.
#다음 장면은 어떻게 이어 가나요?
한 장면을 완성했다면 다음 장면에서도 같은 인물과 공간이 이어져야 해요. 이때 기준을 형태와 색 두 가지로 나눠 넘기면 안정적이에요.
- 📌 형태는 처음 만든 캐릭터 시트와 배경 기준 이미지를 그대로 따라요
- 📌 색과 조명은 확정된 장면을 참고해요. 확정 영상의 색이 시트와 달라졌다면 영상을 다시 만들기보다 시트의 색을 확정 영상에 맞추면 부담이 적어요
확정 장면에서 캡처한 프레임을 다음 장면의 기준 이미지로 계속 넘기면, 넘길 때마다 화질이 조금씩 떨어질 수 있어요. 캡처는 색과 조명을 확인하는 참고로 쓰고, 기준 이미지는 원본을 유지해요.
#오늘 바로 해볼 것
- ✅ 지금 만드는 캐릭터의 고정 특징을 한 문단으로 적고, 모든 요청문 앞에 같은 문단을 붙여 보세요
- ✅ 같은 인물이 두 장면 이상 나온다면 정면 전신, 후면 전신, 얼굴 클로즈업 세 칸짜리 캐릭터 시트를 먼저 만들어 보세요
- ✅ 컷이 어긋났다면 요청문을 고치기 전에 기준 이미지가 몇 장 들어갔는지부터 확인하세요
인물과 공간의 기준을 정했다면 장면 순서를 짤 차례예요. 스토리보드 예시 글에서 컷마다 무엇을 적는지 양식과 함께 볼 수 있어요.
※ 이 글은 2026년 10월 22일 기준으로 작성했어요. 각 도구의 참조 기능 이름과 한도는 버전에 따라 바뀔 수 있으니 공식 문서에서 최신 내용을 확인하세요.